
Chatbots wie ChatGPT, Claude, Gemini oder Copilot beantworten Fragen, schreiben Texte, fassen Dokumente zusammen und programmieren. Dahinter stehen große Sprachmodelle (Large Language Models, LLMs). Sie wirken oft, als würden sie verstehen und denken. Tatsächlich beruhen sie auf einem überraschend einfachen Grundprinzip: der Vorhersage des nächsten Wortes.
Dieser Artikel erklärt verständlich, wie ein Sprachmodell aufgebaut ist und trainiert wird, was Token, Parameter und der Transformer sind, warum Modelle „halluzinieren“ und was das für den Umgang mit KI bedeutet.
Das Grundprinzip: das nächste Wort vorhersagen
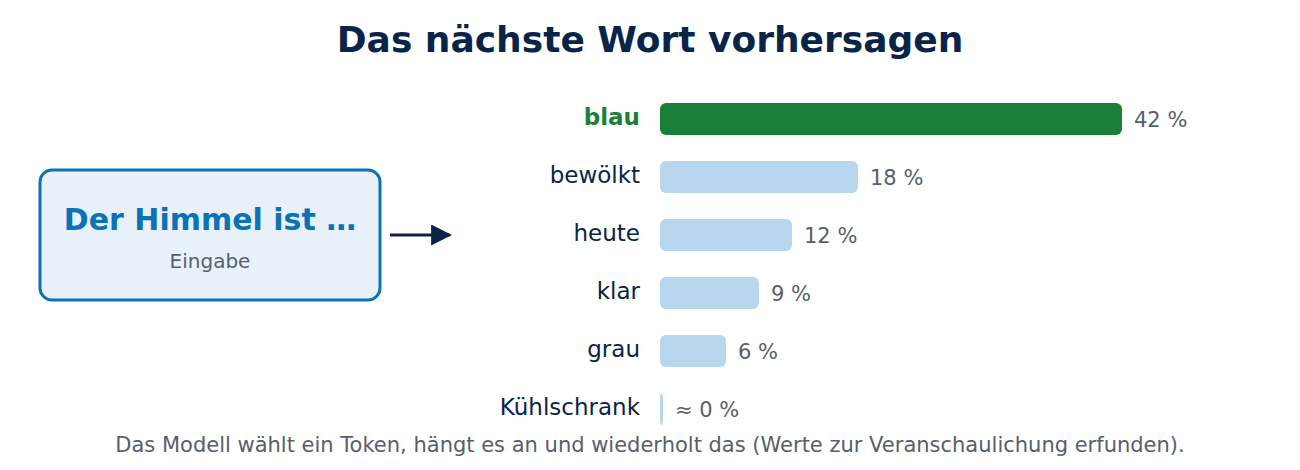
Ein Sprachmodell bekommt einen Text und berechnet, welches Wort (genauer: welches Token) mit welcher Wahrscheinlichkeit als Nächstes folgt. Nach „Der Himmel ist“ sind „blau“, „bewölkt“ und „heute“ wahrscheinlich, „Kühlschrank“ nicht. Das Modell wählt ein Token, hängt es an den Text und wiederholt den Vorgang, Token für Token, bis die Antwort fertig ist.
Damit das zu sinnvollen, langen Antworten führt, muss das Modell sehr viel über Sprache, Fakten, Zusammenhänge und Stil gelernt haben, und genau das passiert im Training.
Token: wie das Modell Text sieht
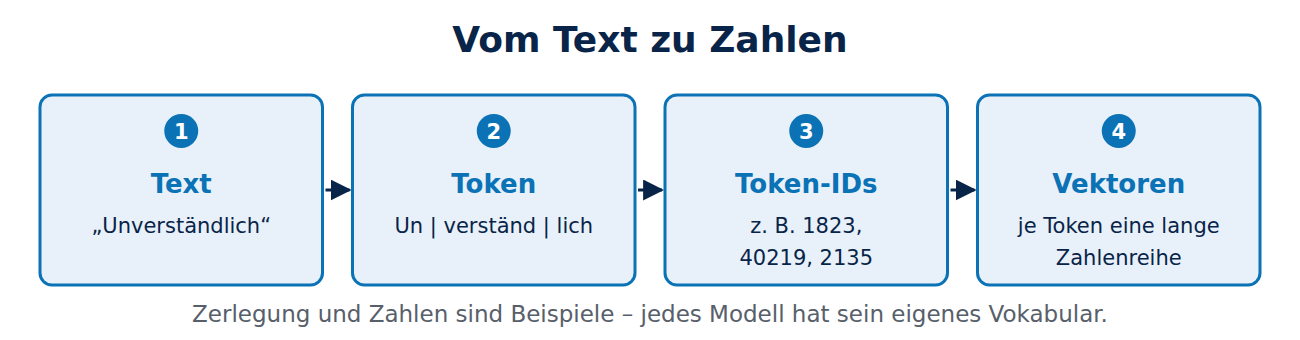
Sprachmodelle zerlegen Text in Token: häufige Wörter, Wortteile oder einzelne Zeichen. „Unverständlich“ könnte etwa aus den Token „Un“, „verständ“ und „lich“ bestehen. Jedes Token wird in eine lange Zahlenreihe (einen Vektor) übersetzt, mit der das Modell rechnet. Die maximale Textmenge, die ein Modell auf einmal berücksichtigen kann, heißt Kontextfenster und reicht heute von einigen tausend bis über eine Million Token.
Das neuronale Netz und seine Parameter
Ein Sprachmodell ist ein riesiges künstliches neuronales Netz: viele Schichten, in denen Zahlen mit Gewichten multipliziert und addiert werden. Diese Gewichte heißen Parameter. Große Modelle haben Milliarden bis Billionen davon. In den Parametern steckt alles, was das Modell gelernt hat, nicht als gespeicherte Texte, sondern als Muster.
Der Transformer und die Aufmerksamkeit
Fast alle heutigen Sprachmodelle beruhen auf der Transformer-Architektur, 2017 von Google-Forschern vorgestellt („Attention Is All You Need“). Ihr Kern ist der Aufmerksamkeitsmechanismus: Für jedes Token berechnet das Modell, welche anderen Token im Text dafür wichtig sind. Im Satz „Der Hund jagte die Katze, weil sie weglief“ lernt es so, dass „sie“ sich auf die Katze bezieht. Viele solcher Aufmerksamkeitsschichten übereinander erfassen Grammatik, Bedeutung und Zusammenhänge über lange Texte.
Wie ein Sprachmodell trainiert wird
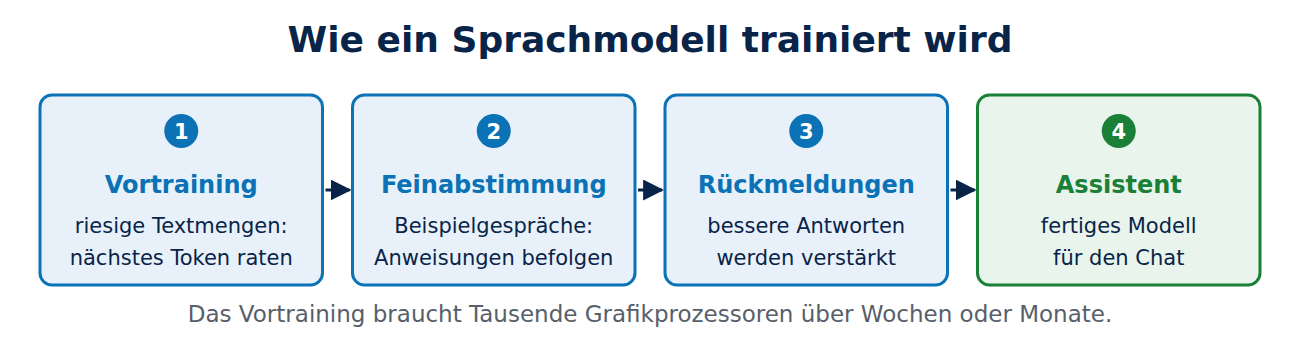
- Vortraining: Das Modell liest riesige Textmengen aus Büchern, Websites, Code und anderen Quellen und lernt, das jeweils nächste Token vorherzusagen. Bei jedem Fehler werden die Parameter ein kleines Stück angepasst. Das erfordert Tausende spezialisierte Grafikprozessoren über Wochen oder Monate.
- Feinabstimmung: Mit ausgewählten Beispielgesprächen lernt das Modell, hilfreich auf Anweisungen zu antworten.
- Training mit Rückmeldungen: Menschen oder andere Modelle bewerten Antworten, und das Modell wird in Richtung besserer, sichererer Antworten verstärkt (etwa Reinforcement Learning from Human Feedback).
Wie die dafür nötigen Chips funktionieren, erklärt der Artikel Wie funktioniert ein Prozessor?
Warum Sprachmodelle „halluzinieren“
Ein Sprachmodell erzeugt plausible Texte, keine geprüften Fakten. Fehlt ihm Wissen oder ist eine Frage mehrdeutig, kann es überzeugend klingende, aber falsche Antworten erzeugen: erfundene Quellen, falsche Zahlen, nicht existierende Gesetze. Man spricht von Halluzinationen. Gegenmittel sind die Anbindung an Websuche oder Dokumente (Retrieval), das Nachprüfen wichtiger Angaben und präzise Fragen.
Was Sprachmodelle können und was nicht
- Stark: Texte formulieren, zusammenfassen und übersetzen, Ideen sammeln, Code schreiben und erklären, Informationen strukturieren.
- Schwächer: exakte Fakten ohne Quelle, aktuelle Ereignisse ohne Websuche, sehr lange exakte Rechnungen ohne Werkzeuge.
- Grenzen: Sie haben kein eigenes Erleben, keine Absichten und keine Garantie für Wahrheit.
Datenschutz und Sicherheit
- Geben Sie keine Passwörter, Gesundheits- oder Firmengeheimnisse in öffentliche Chatbots ein.
- Prüfen Sie die Einstellungen zur Nutzung Ihrer Daten für das Training.
- Für sensible Daten gibt es lokal laufende Modelle oder Unternehmensangebote mit Vertraulichkeitszusagen.
- In der EU regelt der AI Act Pflichten für Anbieter von KI-Systemen.
Wie Verschlüsselung Ihre Daten unterwegs schützt, erklärt Wie funktioniert HTTPS?
Fazit
Ein großes Sprachmodell zerlegt Text in Token und sagt mit einem riesigen neuronalen Netz, meist einem Transformer mit Aufmerksamkeitsmechanismus, das jeweils nächste Token vorher. Gelernt hat es das aus enormen Textmengen, verfeinert durch Beispiele und Rückmeldungen. Das macht es sehr gut im Formulieren, aber nicht unfehlbar: Wichtige Fakten sollten Sie immer prüfen. Weitere Grundlagen finden Sie in der Übersicht Computer- und Software-Grundlagen.
Quellen und weiterführende Links
- Attention Is All You Need (Vaswani et al., 2017, arXiv)
- Künstliche Intelligenz (Bundesamt für Sicherheit in der Informationstechnik)
- Großes Sprachmodell (Wikipedia)

Neueste Kommentare